Numérique responsable, données ouvertes

Comprendre l’énergie du code.

Que révèlent les benchmarks sur la consommation énergétique des langages de programmation ? Explorez les relations entre énergie, temps d’exécution et puissance, à partir de données documentées.

Des observations, avec leur contexte.Les mesures sont historiques. Les configurations ne sont pas entièrement connues. Cette édition ne publie pas de classement universel.

Ce que les données nous apprennent

Trois enseignements à retenir.

Énergie et durée sont fortement liées.

Pour les benchmarks avec plusieurs configurations dans l’échantillon filtré, la corrélation de rang est comprise entre 0,938 et 0,996. Le temps d’exécution est une dimension essentielle de la lecture énergétique.

Examiner les corrélations

Les watts seuls ne suffisent pas.

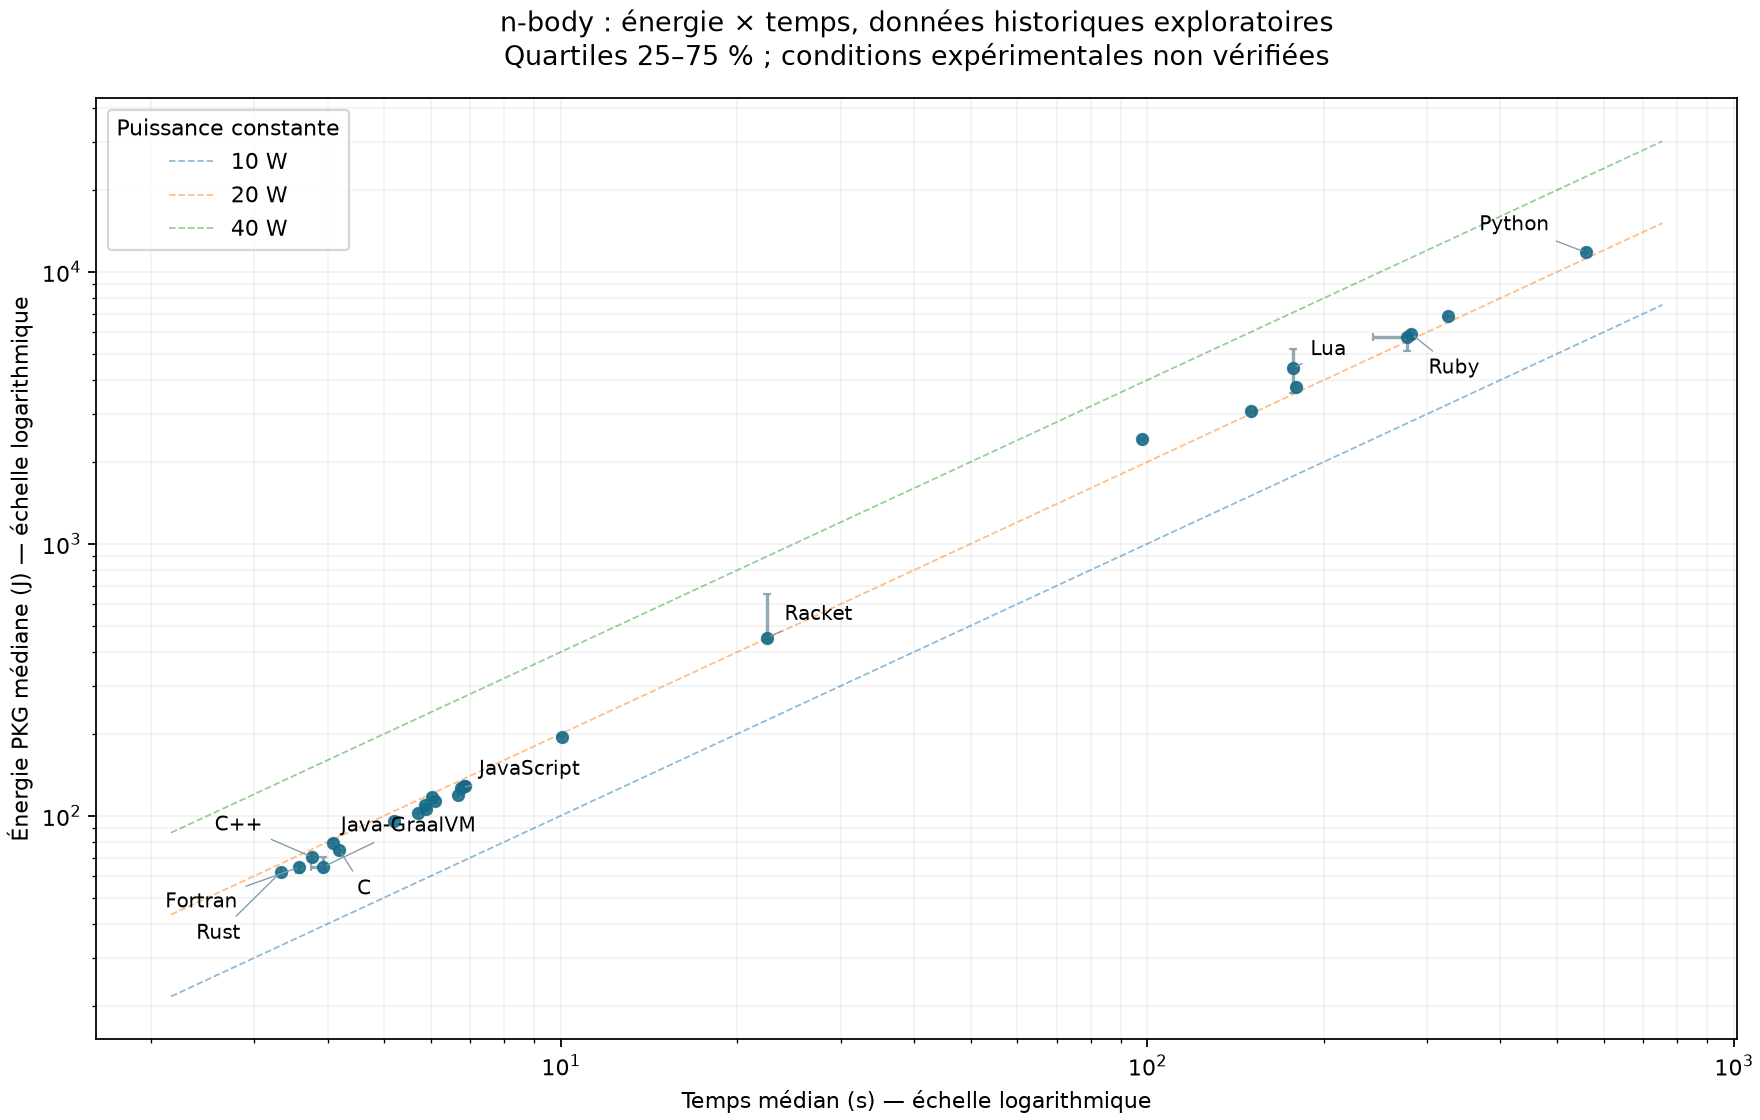
Dans l’exemple n-body, Python/C représente 157,5× l’énergie médiane, contre 1,18× la puissance médiane. La durée aide à comprendre cet écart observé.

Lire le cas n-body

Une conclusion utile doit être vérifiable.

Sources, lignes d’origine, filtres et calculs sont accessibles. Les 253 séries restent consultables, y compris celles qui sont écartées des croisements exploratoires.

Reproduire l’analyse

Ces associations décrivent l’échantillon. Elles ne séparent pas les effets du langage, de l’algorithme, du compilateur et du matériel.
Un résultat, plusieurs dimensions

Quand le temps fait monter l’énergie.

Chaque point représente une configuration retenue pour n-body. Les quartiles montrent la dispersion des observations. Les lignes obliques matérialisent une puissance constante.

Nuage n-body : énergie PKG médiane en joules selon le temps médian en secondes, axes logarithmiques. Les points suivent une forte association positive ; barres des quartiles et lignes de puissance constante à 10, 20 et 40 watts.
Énergie du package processeur, pas consommation totale à la prise. Conditions expérimentales non vérifiées. Périmètre et filtres.

Un corpus accessible

Les chiffres se lisent avec leurs sources.

3 950 observations dans les fichiers principaux, issues de 28 configurations et 11 benchmarks. Les variantes sont conservées séparément pour éviter de compter plusieurs fois certaines mesures.

Parcourir les tableaux
Observations lisibles, variantes incluses
4 450
Lignes principales numériquement invalides
39
Séries écartées des croisements
23
Jeux de données et scripts
Ouverts

Ce que l’INR apporte

Une base plus fiable pour poursuivre le travail.

Cette édition améliore l’outil de mesure et rend les résultats hérités plus faciles à examiner. Elle conserve la licence et les crédits du projet original Green Software Lab.

Les questions qui comptent.

Quel langage de programmation consomme le moins d’énergie ?

Ces données ne permettent pas de désigner un gagnant universel. Le résultat dépend de la tâche, de l’implémentation, des entrées, du compilateur et du matériel. Les tableaux présentent des observations historiques par benchmark, avec leurs limites.

Les résultats sont-ils de nouvelles mesures de l’INR ?

Non. L’INR a amélioré les outils et documenté les CSV hérités. Les corrections logicielles ne valident pas rétroactivement les mesures anciennes.

Peut-on en déduire l’empreinte carbone ou la mémoire utilisée ?

Pas directement. L’énergie PKG ne couvre pas toute la machine. DRAM en joules n’est pas un pic mémoire en octets. Une analyse carbone ou mémoire exige des mesures et des informations complémentaires.

Comment réutiliser le projet ?

Consultez le dépôt sous licence MIT, conservez les attributions, puis adaptez et vérifiez les recettes de benchmark sur votre matériel. La méthode explique comment reproduire les analyses sans lancer de benchmark.